

Una fotografía puede convertirse en el punto de partida de un video donde una persona habla, mueve los labios y cambia de expresión. También es posible escribir unas frases y escucharlas con una voz que nunca las pronunció frente a un micrófono.
Detrás de estos resultados intervienen modelos capaces de generar sonidos e imágenes a partir de instrucciones y referencias.
La tecnología reúne procedimientos diferentes. Sintetizar una voz requiere producir una señal acústica; generar un rostro implica construir información visual; conseguir que ambos parezcan formar parte de una misma escena exige mantener coherencia entre el sonido y el movimiento. Aunque algunas aplicaciones presentan todo esto como una sola función, sus mecanismos pueden ser considerablemente más complejos.
Comprender esa diferencia permite observar el alcance de la IA generativa más allá del resultado final. Una voz convincente o un rostro reconocible son productos de operaciones matemáticas, modelos entrenados y decisiones sobre qué información utilizar.
Una voz nueva a partir de texto o grabaciones
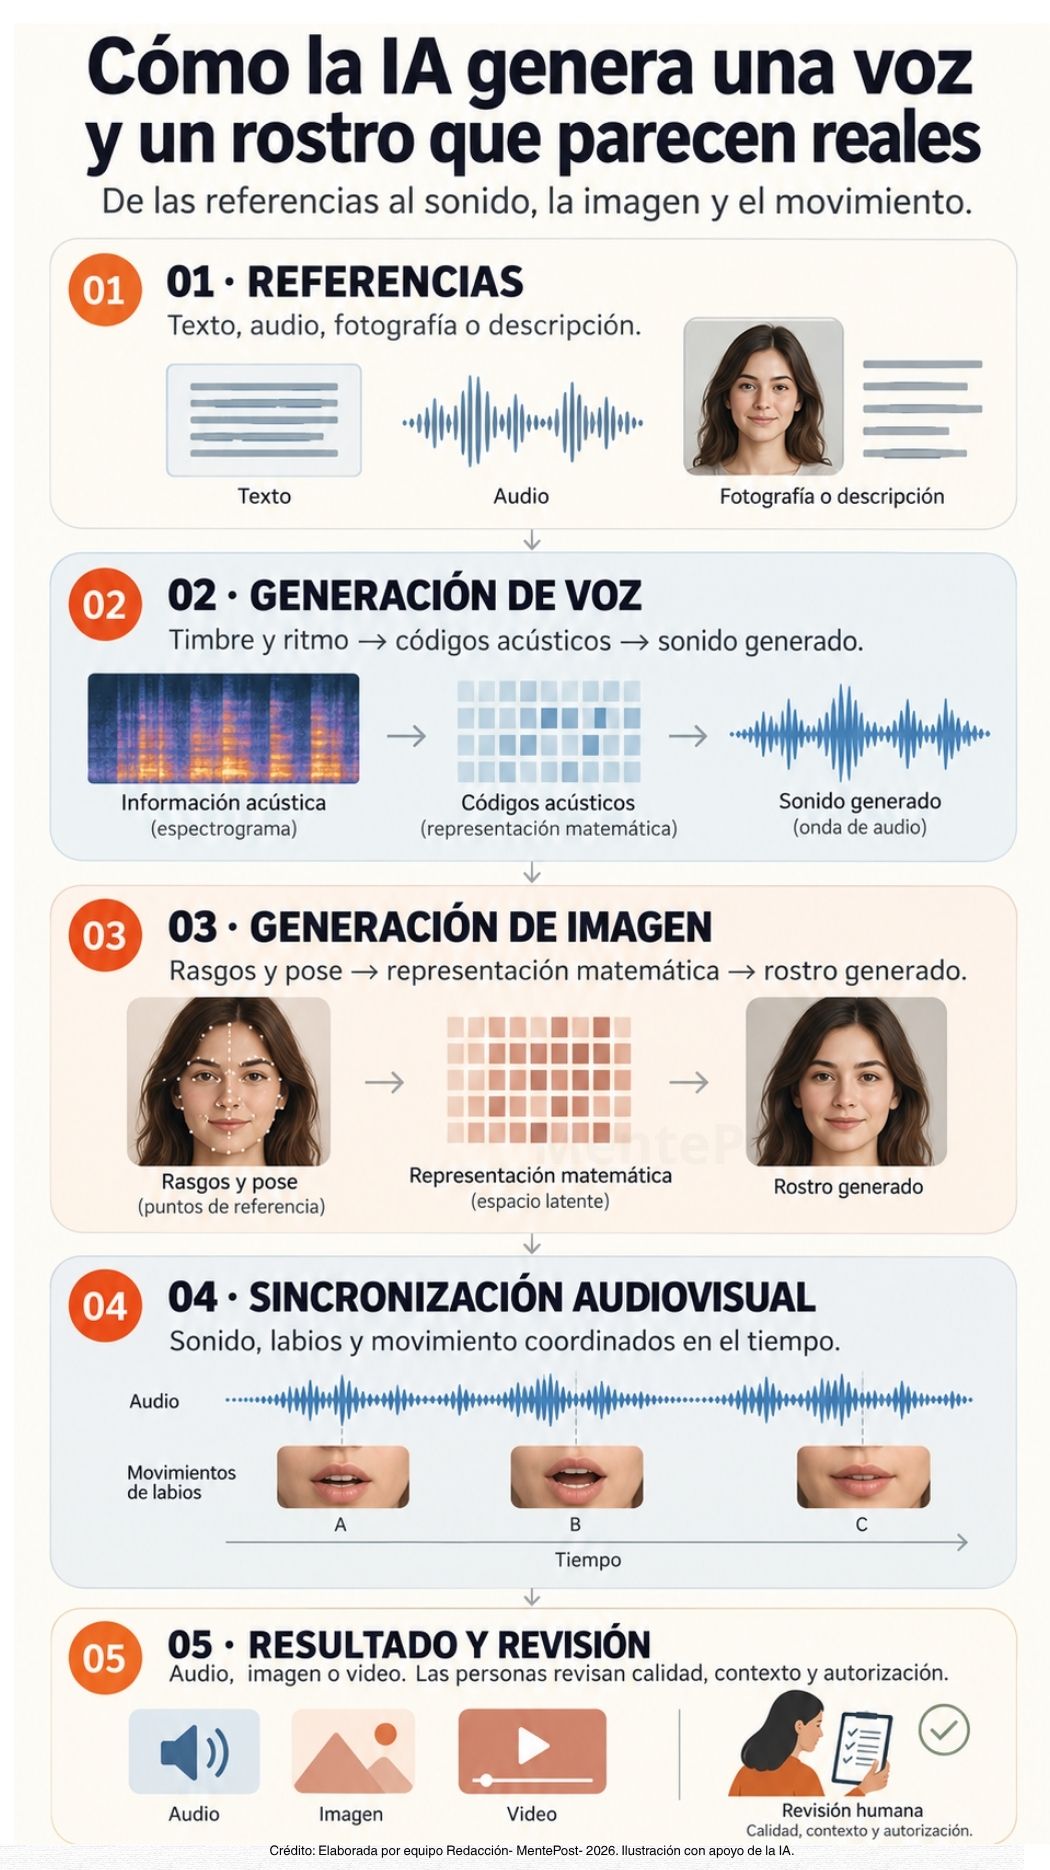
Los sistemas de síntesis de voz transforman información de entrada en una señal sonora. En una modalidad conocida como texto a voz, el punto de partida es una secuencia de palabras que el modelo debe convertir en habla, con una pronunciación, duración y entonación determinadas.
Para conseguirlo, los modelos aprenden regularidades presentes en grandes conjuntos de grabaciones. Entre ellas se encuentran las relaciones entre sonidos y palabras, las variaciones de ritmo y las características acústicas de distintas voces. Durante la generación, el sistema utiliza lo aprendido para producir una secuencia de audio que corresponda al texto solicitado.
Algunas arquitecturas trabajan con representaciones comprimidas del sonido, conocidas como códigos o tokens de audio. Estas unidades digitales permiten representar partes de la información acústica para que el modelo pueda predecir nuevas secuencias, que posteriormente se convierten en audio reproducible.
El modelo VALL-E, presentado por investigadores de Microsoft en 2023, mostró cómo este procedimiento podía utilizar una grabación de apenas tres segundos como referencia para sintetizar nuevas frases con características semejantes a las de un hablante.
Ese resultado no significa que cualquier sistema reproduzca fielmente una identidad con tres segundos de audio. La semejanza depende de la arquitectura, los datos, la calidad de la referencia y las condiciones de generación. También existen modelos que producen voces sintéticas sin recibir grabaciones de una persona específica.
El rostro también se convierte en información matemática
En la generación visual, las entradas pueden ser una descripción escrita, una fotografía, varios fotogramas o una combinación de referencias. El modelo utiliza esa información para orientar la apariencia de la imagen que producirá.
Una familia importante de sistemas utiliza modelos de difusión. Durante su entrenamiento aprenden a recuperar información visual a partir de representaciones alteradas con ruido. Al generar una imagen, comienzan con una representación inicial y la transforman progresivamente, siguiendo las condiciones indicadas por el texto o las imágenes de referencia.
En determinadas arquitecturas, este proceso ocurre en un espacio latente: una representación matemática comprimida de la información visual. En lugar de modificar directamente cada píxel durante todas las operaciones, el modelo trabaja con patrones internos y después los convierte en una imagen visible. Esta técnica permite reducir la cantidad de información que necesita procesarse, aunque no todos los generadores visuales utilizan el mismo procedimiento.
Estos modelos pueden crear un rostro ficticio o modificar una composición existente. Cuando se utiliza la fotografía de una persona, el reto técnico cambia: conservar rasgos reconocibles mientras se alteran elementos como el ángulo, la iluminación, la expresión o el escenario. La fidelidad a la referencia depende del sistema y de los controles disponibles.
Existen además otras arquitecturas generativas, incluidas las que producen secuencias de unidades visuales mediante mecanismos de predicción. Hablar de difusión ayuda a comprender una parte importante de la tecnología, pero no describe todos los modelos de imagen.
Cuando una fotografía comienza a moverse
Generar una imagen fija y producir un video presentan exigencias diferentes. En una fotografía basta con construir una composición visual coherente; en una secuencia, los elementos también deben conservar continuidad mientras cambian de posición, expresión o perspectiva.
Los sistemas de video pueden utilizar información temporal para relacionar distintos fotogramas. Algunos reciben una imagen inicial y generan movimiento a partir de ella. Otros producen secuencias guiadas por descripciones, referencias visuales o fragmentos de video.El modelo debe mantener relaciones entre los elementos de la escena para evitar que un rostro cambie inesperadamente de apariencia o que los movimientos pierdan continuidad.
Los procedimientos tampoco son idénticos. Mientras algunos modelos generan video mediante procesos de difusión, otros utilizan representaciones discretas que permiten predecir unidades visuales sucesivas. VideoPoet, presentado por Google Research en 2023, exploró este segundo enfoque utilizando un modelo capaz de trabajar con información de texto, imagen, video y audio.
Cuando la escena incluye a una persona hablando, aparece otra tarea: coordinar el sonido con los movimientos visibles. Los labios deben corresponder razonablemente con los sonidos pronunciados, mientras la mandíbula, la expresión facial y los movimientos de la cabeza contribuyen a la naturalidad de la interpretación.
Esta coordinación puede apoyarse en relaciones entre los sonidos del habla y sus manifestaciones visuales, aunque distintos sonidos pueden producir movimientos labiales semejantes.
En determinados sistemas, el audio y la imagen se generan mediante componentes especializados que después se integran. Otros modelos audiovisuales aprenden relaciones entre ambas modalidades y pueden producirlas de manera conjunta. Veo, desarrollado por Google DeepMind, es un ejemplo de generación de video con audio integrado, incluidos diálogos y sonidos ambientales.
La sincronización no consiste únicamente en hacer coincidir una boca abierta con una palabra. También intervienen la duración de los sonidos, los movimientos entre fotogramas y la continuidad de la escena. Una pequeña discrepancia puede hacer que el resultado pierda naturalidad, incluso cuando la imagen y la voz parecen convincentes por separado.
Del entrenamiento a la generación: dos momentos diferentes
Una confusión frecuente consiste en pensar que cada vez que utilizamos una herramienta de IA estamos enseñándole desde cero a reproducir una voz o un rostro. En realidad, es importante distinguir el entrenamiento del modelo y la generación de un contenido concreto.
Durante el entrenamiento, el sistema ajusta sus parámetros a partir de numerosos ejemplos para aprender relaciones entre sonidos, imágenes, textos y movimientos. Es un proceso que requiere recursos computacionales y conjuntos de datos. Después, durante la generación (también llamada inferencia), el modelo utiliza las capacidades adquiridas para producir un nuevo resultado.
En ciertos casos puede adaptarse un modelo con información adicional de una persona o de un estilo específico. En otros, basta con proporcionar referencias durante la generación, sin modificar sus parámetros. La cantidad de material necesaria y el grado de semejanza alcanzado varían considerablemente.
Esta distinción ayuda a comprender por qué una fotografía o una grabación pueden utilizarse de maneras diferentes según la tecnología. Una referencia puede orientar una generación concreta, servir para ajustar un modelo o formar parte de otro procedimiento. Son operaciones que conviene diferenciar cuando se habla de reproducir identidades.
Generar una voz, reproducir un rostro y crear una escena audiovisual son procesos distintos, aunque el resultado parezca una sola grabación.
La calidad final también depende de lo que se revisa
Los resultados de estos sistemas pueden contener errores que pasan inadvertidos durante una primera revisión: cambios en los rasgos de un rostro entre escenas, pronunciaciones poco naturales, movimientos inconsistentes o sonidos que no corresponden exactamente con la imagen. La propia documentación de Google DeepMind señala que conseguir una voz natural y bien sincronizada dentro del video sigue siendo un desafío técnico, incluso en modelos con generación audiovisual integrada.
En producciones audiovisuales, la intervención humana puede incluir seleccionar referencias, ajustar instrucciones, comparar versiones, corregir secuencias y decidir si el resultado comunica lo que se buscaba. La calidad visual o sonora tampoco resuelve automáticamente cuestiones relacionadas con la autorización de una voz, la procedencia de una fotografía o el contexto en que se presentará el contenido.
La tecnología ofrece distintas maneras de crear voces, rostros y escenas. Comprender sus procesos permite distinguir entre una capacidad técnica, la calidad del resultado y las decisiones de quienes lo producen.
Una voz generada a partir de códigos acústicos y un rostro construido mediante representaciones matemáticas pueden terminar formando una escena que parece completamente natural.
Estas tecnologías amplían las posibilidades de crear videos, personajes y nuevas formas de contar historias, pero también transforman nuestra experiencia cotidiana en internet, donde las voces y los rostros que vemos y escuchamos pueden tener un origen distinto al que imaginamos.
▏
Desde la investigación
- Microsoft Research, 2023. Presenta VALL-E, un modelo de síntesis de voz basado en códigos acústicos y grabaciones breves de referencia.
- Hugging Face / Diffusers. Explica los componentes de los modelos de difusión y sus procesos de generación visual.
- Rombach y colaboradores, 2022. Describen los modelos de difusión latente, que permiten generar imágenes mediante representaciones matemáticas comprimidas.
- Google Research, 2023. Presenta VideoPoet, una investigación sobre generación de video y audio mediante secuencias de unidades digitales.
- Google DeepMind. Documenta las capacidades de Veo, incluida la generación audiovisual y las dificultades de sincronización y naturalidad del habla.
- Google Research, 2026. Analiza la continuidad en videos generados con IA, especialmente la conservación de personajes, escenarios y coherencia entre secuencias.