

Alguien lleva varios días desarrollando un proyecto con inteligencia artificial. Ha revisado documentos, corregido propuestas y establecido decisiones importantes. Sin embargo, después de numerosas interacciones, el asistente comienza a sugerir opciones que habían sido descartadas o solicita información que ya se había proporcionado.
La conversación continúa abierta. Los mensajes anteriores siguen visibles y aparentemente todo permanece en su lugar. ¿Por qué, entonces, la inteligencia artificial parece haber perdido parte del contexto?
La explicación se encuentra en una diferencia técnica que comienza a adquirir importancia conforme utilizamos estos sistemas para tareas prolongadas: el historial de una conversación y la información disponible para generar una respuesta son componentes distintos.
Una conversación guardada y una ventana de contexto
Los modelos de lenguaje trabajan con una cantidad limitada de información en cada proceso de generación. Esa capacidad recibe el nombre de ventana de contexto y comprende el material que el modelo puede considerar al elaborar una respuesta.
En una aplicación conversacional, ese material puede incluir instrucciones del sistema, mensajes recientes, fragmentos de intercambios anteriores, documentos y resultados obtenidos mediante herramientas externas. La composición exacta depende del modelo, la aplicación y sus mecanismos de administración del contexto.
OpenAI explica en su documentación para desarrolladores que las conversaciones pueden conservarse como objetos persistentes, incluso entre diferentes sesiones. Sin embargo, conservar esos registros plantea un desafío diferente al de introducir su contenido dentro de la ventana de contexto de un modelo.
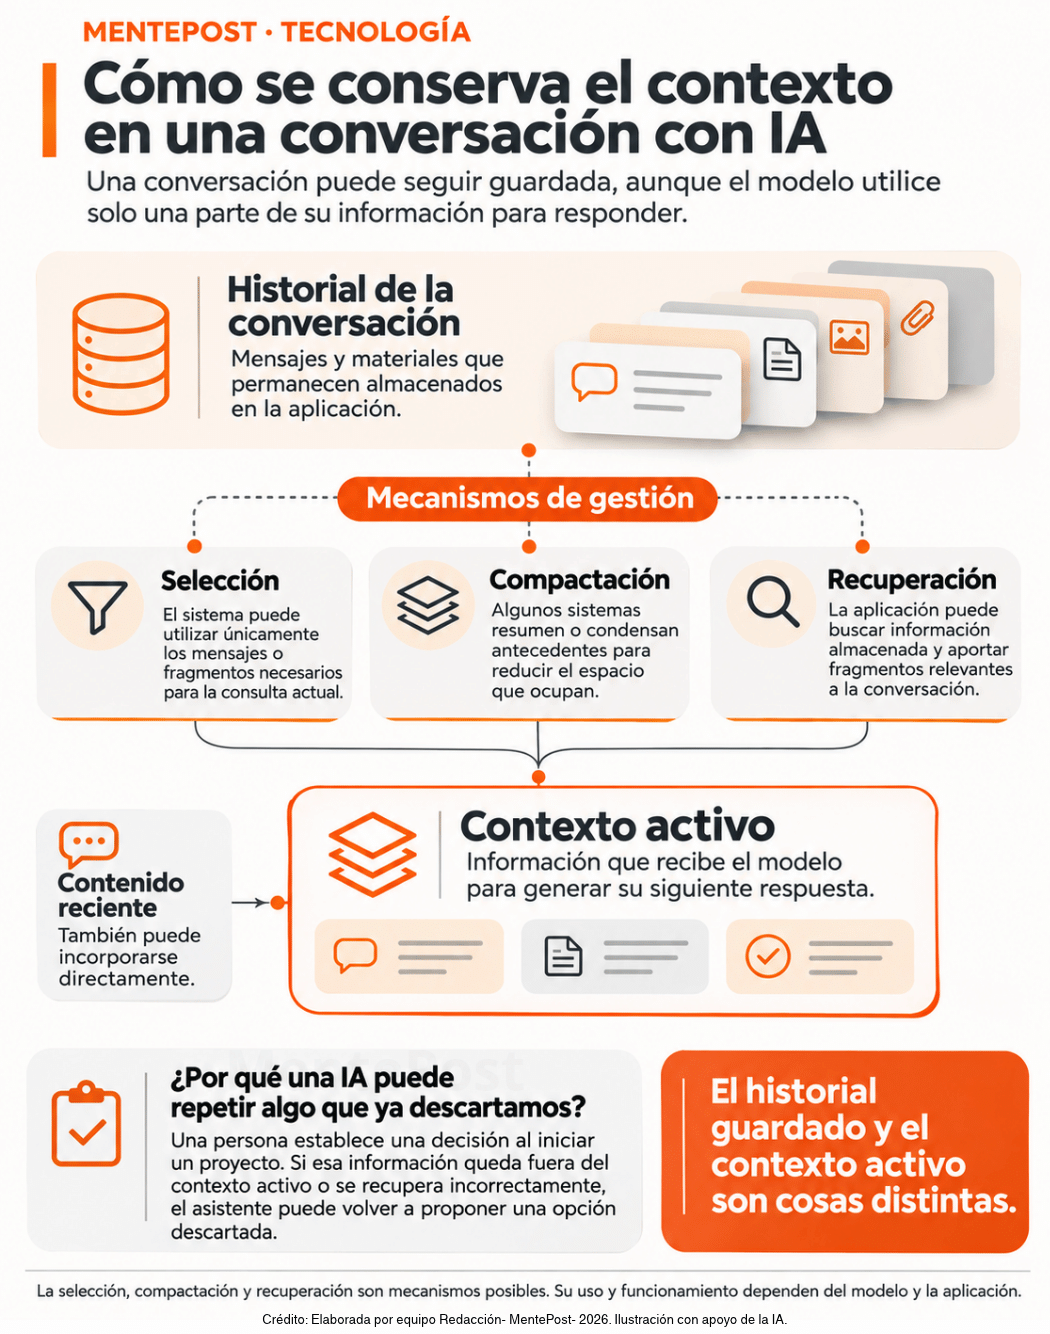
Por ejemplo, una aplicación puede almacenar cientos de mensajes y seleccionar solamente una parte para atender una nueva consulta. Así, el historial visible ofrece continuidad documental, mientras el contexto activo determina qué información está disponible directamente para procesar la solicitud.
Esta distinción ayuda a comprender por qué encontrar un mensaje anterior en la pantalla es diferente de que la IA lo esté utilizando en su respuesta actual.
Los tokens determinan cuánto puede procesarse
Para administrar ese espacio, los modelos utilizan unidades llamadas tokens. Un token puede representar una palabra completa, una parte de ella, signos de puntuación u otros fragmentos de información.
La extensión disponible depende del modelo y se expresa habitualmente mediante la cantidad máxima de tokens que admite su ventana de contexto. En ese espacio deben considerarse las entradas y las respuestas generadas; dependiendo de la arquitectura, también intervienen otros componentes del procesamiento.
Una conversación extensa puede acumular miles de tokens mediante preguntas, respuestas, instrucciones, documentos y resultados de herramientas. Incluso cuando el usuario escribe mensajes breves, el intercambio puede crecer considerablemente si el asistente produce análisis largos o trabaja con archivos.
Los modelos actuales permiten manejar cantidades de contexto mucho mayores que generaciones anteriores. Sin embargo, una ventana más amplia sigue teniendo un límite y plantea otra cuestión: disponer de más información tampoco garantiza identificar correctamente cada detalle importante.
La administración del contexto se convierte, por tanto, en parte fundamental del diseño de los asistentes conversacionales.
Qué sucede cuando la conversación crece demasiado
Existen diferentes estrategias para manejar conversaciones que se aproximan a los límites del modelo. Una consiste en seleccionar los intercambios más recientes o relevantes. Este procedimiento permite continuar una tarea utilizando menos información, aunque algunos antecedentes pueden quedar fuera de la nueva solicitud.
Otra posibilidad es resumir partes anteriores de la conversación y conservar una representación más breve de su contenido. También pueden emplearse sistemas capaces de localizar información específica dentro de documentos, registros u otros recursos almacenados. Cada estrategia resuelve una necesidad distinta. Seleccionar mensajes reduce la cantidad de contenido que debe procesarse; resumir busca preservar las decisiones principales; recuperar información permite incorporar antecedentes cuando resultan necesarios.
Estos mecanismos pueden combinarse, pero dependen de cómo esté diseñada cada aplicación. Por ello, dos asistentes que parecen ofrecer conversaciones similares pueden administrar sus antecedentes de maneras diferentes.
La compactación permite continuar, pero también selecciona
Una de las técnicas documentadas por OpenAI y Anthropic recibe el nombre de compaction, o compactación del contexto. Su propósito es reducir la cantidad de información que ocupa una conversación extensa y conservar el estado necesario para continuar trabajando.
En la API de OpenAI, la compactación puede producir una representación reducida del estado previo que se utiliza en interacciones posteriores. Anthropic también documenta mecanismos que sustituyen partes antiguas de una conversación por un resumen cuando el contexto alcanza determinados umbrales.
La ventaja resulta evidente para proyectos que requieren muchas sesiones: es posible mantener objetivos, instrucciones y decisiones fundamentales sin procesar continuamente el historial completo.
Sin embargo, compactar también significa seleccionar información. Un resumen puede conservar el objetivo general de un proyecto y omitir una preferencia secundaria, una corrección puntual o la razón por la que se descartó determinada propuesta. Esto introduce una cuestión importante: la calidad de la continuidad depende de qué información consigue preservar el mecanismo utilizado.
Una conversación puede conservar toda su historia, pero la respuesta de una IA depende del contexto que tiene disponible en ese momento.
Recuperar información es otra forma de mantener el hilo
Los sistemas conversacionales también pueden utilizar mecanismos de recuperación de información, conocidos en ciertos diseños como Retrieval-Augmented Generation (RAG). En lugar de incorporar grandes colecciones de documentos al contexto de cada respuesta, una aplicación puede buscar fragmentos relacionados con la consulta actual y proporcionarlos al modelo.
Por ejemplo, si alguien pregunta por una decisión tomada durante un proyecto, un sistema con acceso a registros adecuados podría localizar el documento o fragmento donde quedó establecida y utilizarlo para elaborar la respuesta.
OpenAI documenta este enfoque mediante herramientas de búsqueda semántica y recuperación de archivos. Son mecanismos que permiten aprovechar información almacenada fuera del contexto inmediato. La memoria personalizada de algunos asistentes introduce otra capa. Puede conservar o recuperar preferencias e información relevante de conversaciones anteriores, de acuerdo con las funciones y configuraciones disponibles.
En ChatGPT, por ejemplo, la documentación distingue entre el historial de conversaciones y la información que sus funciones de memoria pueden utilizar para personalizar respuestas. También aclara que recordar información relevante implica seleccionar contenido, en lugar de conservar necesariamente cada detalle.
Por eso conviene diferenciar tres elementos: el historial almacenado, el contexto que utiliza el modelo y la memoria que una aplicación puede recuperar. Aunque interactúan, cumplen funciones distintas.
Cómo conservar la continuidad en proyectos extensos
Cuando trabajamos durante varios días con un asistente, algunas prácticas ayudan a reducir la pérdida de información importante. Una de ellas consiste en establecer periódicamente un resumen de continuidad que incluya el objetivo del proyecto, las decisiones aprobadas, los cambios pendientes y las restricciones que deben mantenerse.
También resulta útil conservar documentos de referencia, identificar versiones definitivas y recuperar los fragmentos originales cuando una decisión requiere precisión. De esa manera, la continuidad depende de información verificable y puede reconstruirse con mayor facilidad.
Estas prácticas adquieren especial valor cuando una conversación debe trasladarse a otra sesión, plataforma o entorno de trabajo.
Conviene recordar que una respuesta incorrecta sobre antecedentes también puede deberse a instrucciones ambiguas, errores de recuperación o interpretaciones equivocadas. La pérdida del hilo tiene diferentes causas y la extensión de una conversación es solamente una de ellas.
Una memoria digital que necesita contexto
En el artículo de Ciencia sobre la confianza y la incomodidad ante los recuerdos de una IA, exploramos cómo las referencias a conversaciones anteriores pueden modificar nuestra percepción de estos asistentes. La perspectiva tecnológica permite completar esa explicación: para utilizar información anterior, un sistema necesita conservarla, seleccionarla o recuperarla, además de incorporarla adecuadamente a la tarea actual.
Esta arquitectura también ayuda a comprender por qué la memoria de nuestras conversaciones con IA representa un cambio importante en nuestra manera de trabajar con herramientas digitales.
A medida que desarrollamos proyectos cada vez más largos, la continuidad se convierte en una capacidad esencial de los asistentes. El desafío técnico consiste en administrar grandes cantidades de información y recuperar los antecedentes que realmente necesitan las nuevas decisiones.
El futuro de las conversaciones prolongadas con IA dependerá tanto de la capacidad para procesar información como de la precisión con la que los sistemas logren conservar y recuperar su contexto.
▏
Desde la investigación
- OpenAI, Conversation State. Documentación sobre persistencia de conversaciones, administración del contexto, tokens y límites de los modelos.
- OpenAI, Compaction. Guía técnica sobre reducción del contexto y conservación del estado necesario para continuar interacciones extensas.
- Anthropic, Compaction Overview. Documentación sobre mecanismos de compactación y sustitución de partes anteriores de una conversación por representaciones resumidas.
- OpenAI, Retrieval. Documentación sobre búsqueda semántica y recuperación de información relevante almacenada fuera del contexto inmediato.
- OpenAI, Memory in ChatGPT. Explicación de las funciones de memoria, historial y personalización del asistente.